System One AI: Đừng đốt 800ms chỉ để lấy một từ khóa rẽ nhánh
Khám phá System One AI với TypeSafe Jev: thay thế LLM chậm chạp bằng Typed Decisions, phân phối xác suất và 3 primitive Choice, Score, Noul trong thực tế.
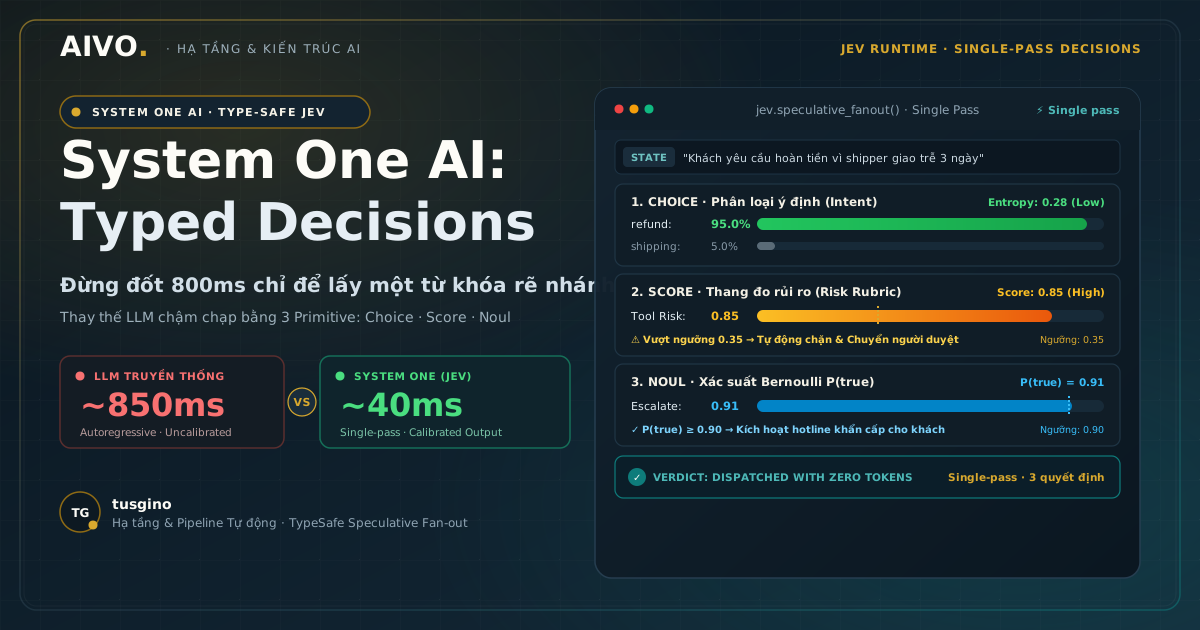
if-else. Mô hình System One trả về Typed Decisions kèm phân phối xác suất đã hiệu chuẩn, không sinh một token văn bản nào.Nghịch lý 800ms của kỹ sư phần mềm
Hãy nhìn vào một đoạn code định tuyến tin nhắn khách hàng quen thuộc trong các hệ thống Agent hiện nay:
// Cách làm ngây thơ mà chúng ta vẫn đang dùng mỗi ngàyconst response = await openai.chat.completions.create({ model: "gpt-4o", response_format: { type: "json_object" }, messages: [ { role: "system", content: "Hãy phân loại tin nhắn này vào 1 trong 2 nhóm: 'refund' hoặc 'shipping'." }, { role: "user", content: customerMessage } ]});const route = JSON.parse(response.choices[0].message.content).intent;Nếu đứng ở góc độ một kỹ sư hạ tầng và automation, đoạn code trên là một sự lãng phí tột cùng:
- Độ trễ khủng khiếp: Bạn tiêu tốn 800ms đến 1.5 giây chỉ để nhận về một chuỗi vỏn vẹn 6 ký tự (
"refund"). - Chi phí token bất hợp lý: Bắt GPU chạy autoregressive decoding sinh ra hàng chục token JSON cú pháp rườm rà.
- Ảo giác cấu trúc (Schema Fragility): Dù dùng Structured Outputs, mô hình sinh chữ vẫn có xác suất sinh chuỗi lạ hoặc timeout.
- Mù mờ về độ tin cậy (Uncalibrated Guess): Chuỗi JSON trả về cho bạn biết model chọn
"refund", nhưng nó không cho bạn biết nó tự tin 99% hay nó chỉ đang tung đồng xu 51% vs 49%.
Đó là lý do chúng ta cần một bước chuyển dịch tư duy: System One Model.
Khái niệm cốt lõi: System One Model là gì?
System One Model là mô hình AI không sinh văn bản. Nó chạy một lượt suy luận duy nhất rồi trả về quyết định đã có kiểu dữ liệu (Typed Decision) kèm phân phối xác suất đã hiệu chuẩn, thay vì decode từng token như LLM.
Tên gọi này mượn từ tâm lý học. Nhà kinh tế học Daniel Kahneman từng chia tư duy con người thành hai cơ chế trong Thinking, Fast and Slow:
- Hệ thống 2 (System Two): Chậm rãi, suy luận logic từng bước, tốn nhiều năng lượng (tương tự các mô hình Reasoning và LLM sinh text dài).
- Hệ thống 1 (System One): Nhanh như chớp, phản xạ trực giác, nhận diện mẫu trong tích tắc dựa trên xác suất tích lũy.
Xem dữ liệu diagram
type: flowchart
title: Luồng xử lý System One Model
desc: Năm bước từ Input Request qua Vector Logits đến Gating và Thực thi an toàn
nodes:
  - id: input
    label: Input Request
    sub: User prompt / Chat / API
    kind: input
  - id: sys1
    label: System One Engine
    sub: Single Pass Vector Logits
    focal: true
  - id: typed
    label: Typed Decision
    sub: Choice, Score hoặc Noul
    focal: true
  - id: gate
    label: Threshold Gating
    sub: Kiểm tra Confidence & Risk
    kind: security
  - id: exec
    label: Safe Automation
    sub: Thực thi tự động hoặc chuyển người
edges:
  - [input, sys1]
  - [sys1, typed]
  - [typed, gate]
  - [gate, exec]
Tháng 9/2026, TypeSafe AI (thành lập bởi Diogo Almeida — cựu nghiên cứu viên OpenAI và đồng tác giả kỹ thuật RLHF) công bố Jev, mô hình chuyên trách đầu tiên cho System One (xem tài liệu primitive chính thức). Giá niêm yết $42/Btok, tương đương $0.042 cho mỗi triệu input token, và output token miễn phí — Jev 1.13 thậm chí được phát hành kèm trọng số mở.
Triết lý của System One rất dứt khoát: AI không sinh văn bản (No Text Generation). AI chỉ đưa ra các quyết định có kiểu dữ liệu (Typed Decisions) đi kèm phân phối xác suất đã hiệu chuẩn (Calibrated Distribution).
- Sinh token tuần tự (800ms - 2000ms).
- Trả về text/JSON: để lấy được quyết định, code phải parse và tự tin vào định dạng.
- Tính tiền cả input lẫn output token — phần JSON sinh ra cũng bị tính.
- Dễ “đoán mò” khi câu hỏi mơ hồ.
- Suy luận trực tiếp qua embedding & classification head.
- Trả về kiểu dữ liệu tĩnh + phân phối xác suất cho từng phương án.
- Chỉ tính tiền input token; output token miễn phí.
- Cho phép đo lường độ phân vân (Entropy) để dừng an toàn.
Ba Primitive Nền Tảng của Typed Decision
Ba primitive này là toàn bộ ngữ pháp của System One: Choice để chọn một nhãn, Score để đo một mức độ, Noul để trả lời Có/Không kèm xác suất.
Xem dữ liệu diagram
type: layers
title: Kiến trúc Speculative Fan-out
desc: Bốn tầng xử lý song song trong một lượt suy luận duy nhất của mô hình System One
nodes:
  - id: state
    label: 1. Input State (Ngữ cảnh)
    sub: Khách hàng khiếu nại / Chat log / Lệnh shell
    kind: input
  - id: jev
    label: 2. Jev Engine (Single-pass)
    sub: Một lượt suy luận ma trận duy nhất
    focal: true
  - id: fanout
    label: 3. Parallel Typed Decisions
    sub: Choice (Ý định) · Score (Mức độ) · Noul (Gọi điện)
    focal: true
  - id: pipeline
    label: 4. Gating & Decision Pipeline
    sub: Tự động hoá an toàn hoặc chuyển con người
    kind: security
edges:
  - [state, jev]
  - [jev, fanout]
  - [fanout, pipeline]
1. Choice — Phân loại đa lớp và hình dạng phân phối
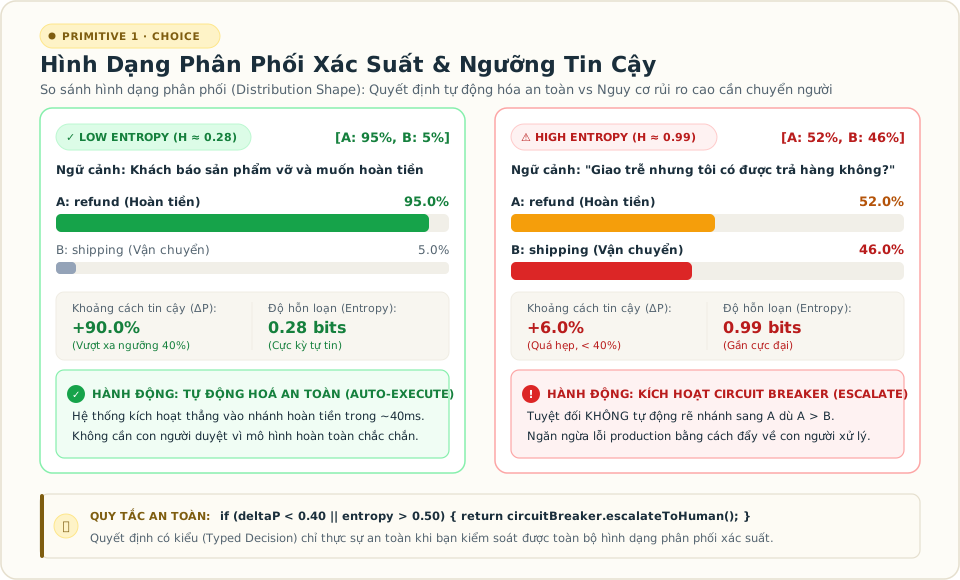
Choice chọn 1 nhãn từ danh sách định sẵn (tối đa 255 nhãn). Điểm tối quan trọng: nó không chỉ trả về nhãn thắng cuộc, mà trả về toàn bộ hình dạng phân phối xác suất (Distribution Shape).
Nếu kết quả là [A: 95%, B: 5%], mô hình cực kỳ chắc chắn. Nhưng nếu kết quả là [A: 52%, B: 46%], dù , tự động chọn là một lỗi production đang chờ xảy ra — độ hỗn loạn (Entropy) quá cao để tin.
2. Score — Thang đo thứ tự (Ordinal Scale)
Thay vì phân loại rời rạc, Score đánh giá mức độ trên thang đo định lượng (thường từ 0.0 đến 1.0, hoặc rubric 1 đến 5 sao). Giá trị trả về là trung bình gia quyền theo xác suất của toàn bộ thang đo:
- Đo lường mức độ nghiêm trọng của sự cố (Severity:
0.92). - Chấm điểm độ độc hại / rủi ro của câu lệnh tool (Risk Score:
0.85).
3. Noul — Xác suất Bernoulli 0 đến 1
Noul (viết tắt chơi chữ từ Bernoulli) giải quyết các câu hỏi dạng Có/Không. Noul không phải là kiểu boolean true/false thô ráp. Noul trả về một số thực:
Tại sao không để AI trả về boolean? Bởi vì ngưỡng ra quyết định (Confidence Threshold) là đặc quyền của kỹ sư hệ thống, không phải của mô hình!
- Với tác vụ gửi email gợi ý: Chỉ cần là được phép gửi.
- Với tác vụ trừ tiền trong ví: Phải yêu cầu .
Khu Vực Thực Hành: Hands-on Labs
Dưới đây là 3 kịch bản thực tế mô phỏng cách tích hợp System One Model vào kiến trúc phần mềm hiện đại:
Choice("intent", …) gửi cả nhãn lẫn mô tả cho model, nên mô tả chính là chỗ bạn dạy nó phân biệt hai nhãn gần nghĩa. Xoá mô tả đi là mô hình phải đoán.
Chưa có phân phối. Bấm EVALUATE_DECISION để gọi TypeSafe.
Ngưỡng tin cậy chỉ có ý nghĩa sau khi có phân phối xác suất thật. Gọi TypeSafe trước, rồi kéo ngưỡng để thấy Circuit Breaker đổi trạng thái.
Chip là 3 lệnh mẫu — chọn xong vẫn sửa được. Nhãn trên chip là nhận định của con người, còn điểm rủi ro bên phải do mô hình chấm: hãy đối chiếu hai bên.
Score("risk", criteria=[…]) nhận danh sách mức xếp từ thấp đến cao; mỗi mức là một câu mô tả đầy đủ, vì đó chính là thứ mô hình dùng để chấm điểm. Gộp còn 2 mức thì mọi lệnh chỉ còn "an toàn" hoặc "nguy hiểm".
git statusChỉ đọc trạng thái git worktree. Không thay đổi filesystem.
Confidence: —
Trần rủi ro chỉ chặn được điều gì đó sau khi mô hình trả về điểm thật. Bấm EVALUATE_TOOL_RISK để chấm lệnh này.
Ba câu hỏi chạy trong một lượt gọi HTTP duy nhất: Score cho mức độ, Choice cho định tuyến, Noul cho câu hỏi Có/Không. Sửa ở đây thì mô hình chấm theo đúng thứ bạn vừa định nghĩa.
…Một lượt gọi HTTP duy nhất, ba câu hỏi chạy song song trên cùng ngữ cảnh. Không có văn bản nào được sinh ra để parse.
Hai mẫu kiến trúc bắt buộc phải nhớ
Từ 3 bài lab thực hành trên, hai bài học kiến trúc định hình toàn bộ cách chúng ta xây dựng Agent thế hệ mới:
1. Tool Risk Gating (Cổng phòng vệ cho AI Agent)
Khi trao cho Agent quyền thực thi các lệnh nguy hiểm (Shell script, Database mutation, API gọi ra bên ngoài), việc dựa vào prompt “hãy cẩn thận” là vô nghĩa.
Thay vào đó, trước mọi lượt chạy tool, ta dùng primitive Score để đo lường Risk Score. Nếu lệnh vượt ngưỡng an toàn (), hệ thống tự động chặn lại (Intercept) và yêu cầu chữ ký phê duyệt từ con người (Human-in-the-loop).
const risk = await jev.score(toolCall.command, {  rubric: "0.0: Read-only safe -> 1.0: Irreversible destruction"});
if (risk > 0.35) {  await requestHumanApproval({ command: toolCall.command, riskScore: risk });  return;}
await sandbox.execute(toolCall.command);
2. Speculative Fan-out (Gom nhánh suy luận)
Thay vì thực hiện 3 lệnh API nối tiếp nhau tới LLM:
- Hỏi cảm xúc khách hàng? (800ms)
- Hỏi ý định chính? (800ms)
- Có cần gọi điện gấp không? (800ms)
System One cho phép gom cả 3 câu hỏi vào một lượt gọi API duy nhất (POST /v1/systemone). Jev nạp state một lần rồi đánh giá mọi câu hỏi song song trên cùng ngữ cảnh đó, nên cả 3 quyết định luôn nhất quán với nhau — điều mà 3 lượt gọi tuần tự không đảm bảo được.
Các bước triển khai cho dự án của bạn
- Xác định điểm nghẽn routingKiểm tra các luồng trong codebase đang dùng LLM chỉ để lấy về boolean hoặc enum.
- Thiết kế Schema PrimitivesThay thế câu prompt dài dòng bằng các định nghĩa chuẩn
Choice,ScorevàNoul. - Cấu hình Confidence ThresholdThiết lập ngưỡng tin cậy và cơ chế Circuit Breaker đẩy về con người khi mô hình phân vân.
- Đo lường độ trễ thậtĐo P95 latency và chi phí token trên chính dữ liệu của bạn. Đừng tin một con số benchmark chung: ngữ cảnh dài và câu hỏi phức tạp đều làm độ trễ thay đổi.
Quyết định có kiểu dữ liệu là quyết định ít bất ngờ nhất. Đừng bao giờ để AI phỏng đoán mà không kiểm soát được phân phối xác suất.
— tusgino
- Dừng việc ép LLM sinh text JSON chỉ để phục vụ logic rẽ nhánh
if-else. - System One Model (Jev) trả về Typed Decisions kèm phân phối xác suất, không sinh văn bản và không tính tiền output token.
- Bộ 3 primitive Choice, Score, Noul giúp bạn kiểm soát rủi ro nhờ phân phối xác suất đã hiệu chuẩn.
- Luôn đặt Confidence Threshold để kích hoạt Circuit Breaker khi độ bất định (Entropy) vượt ngưỡng an toàn.
Câu hỏi thường gặp
System One Model khác gì so với LLM truyền thống?
Tại sao Noul không phải là kiểu Boolean thông thường?
Speculative Fan-out hoạt động như thế nào?
Khi nào vẫn nên dùng LLM thay vì System One Model?
Bài liên quan
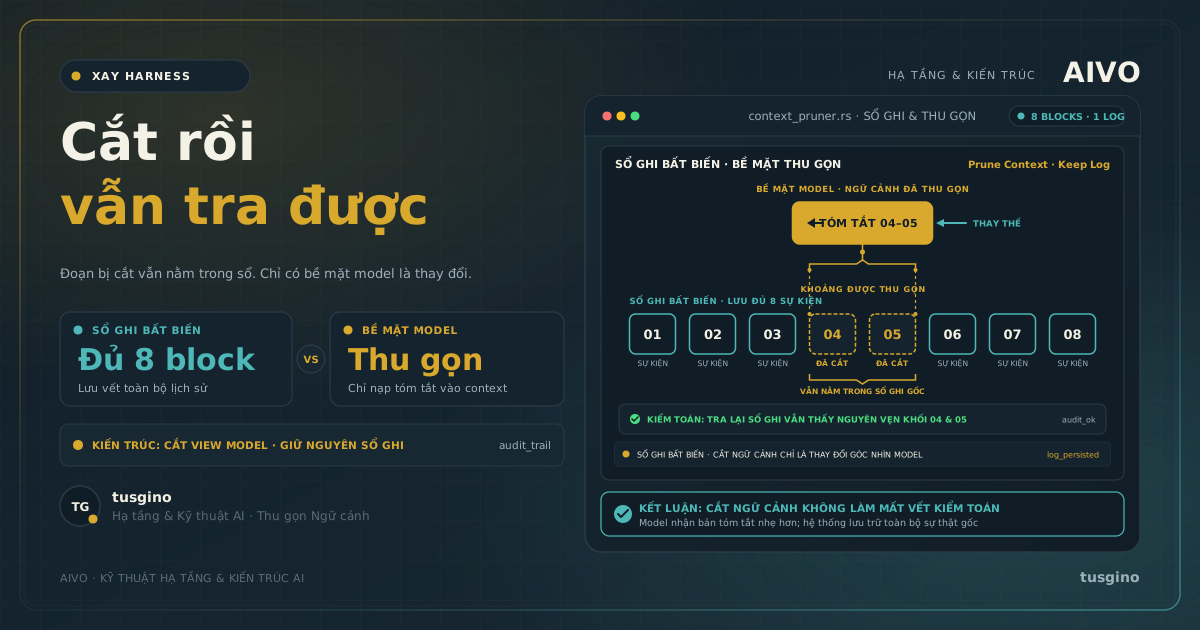
Cắt ngữ cảnh mà vẫn tra lại được
Compaction không xoá gì cả. Nó chỉ che một khoảng trên bề mặt gửi cho model, ghi lại đúng khoảng đã che, và để nguyên bản gốc trong sổ để lần sau tra lại.
Coverage 100% mà vẫn không chạy
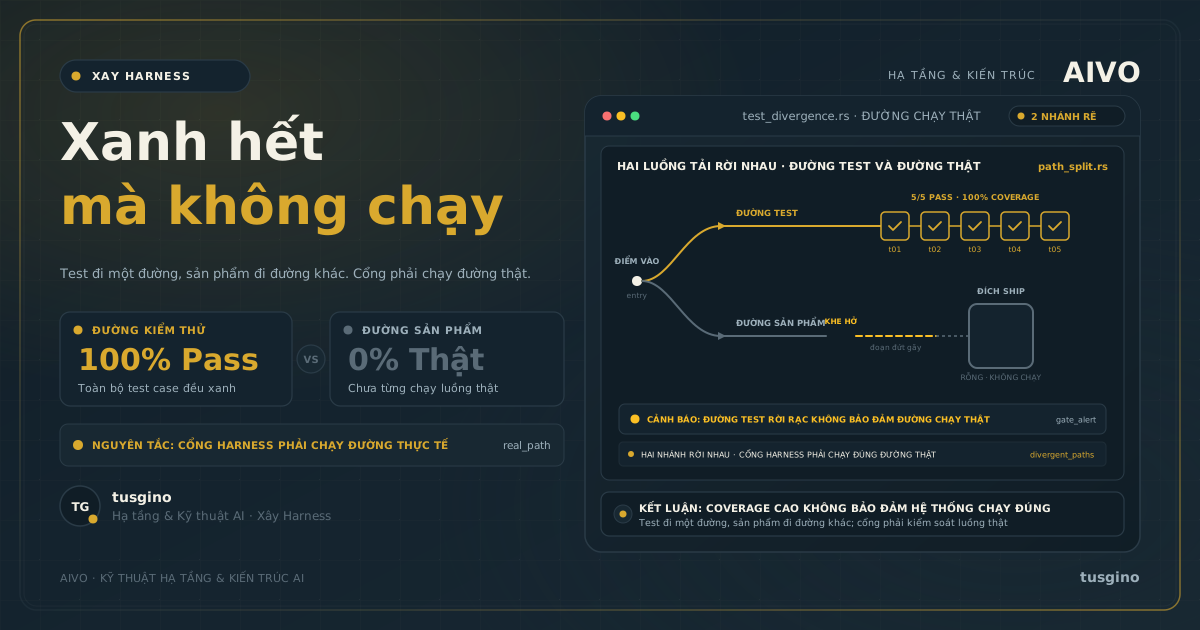
Một tính năng chết hẳn trong sản phẩm, trong khi 178 test xanh và coverage vẫn 100%. Coverage đo dòng đã chạy, chứ không đo đường mà sản phẩm thật sự đi.
Cửa sổ ngữ cảnh không phải trí nhớ
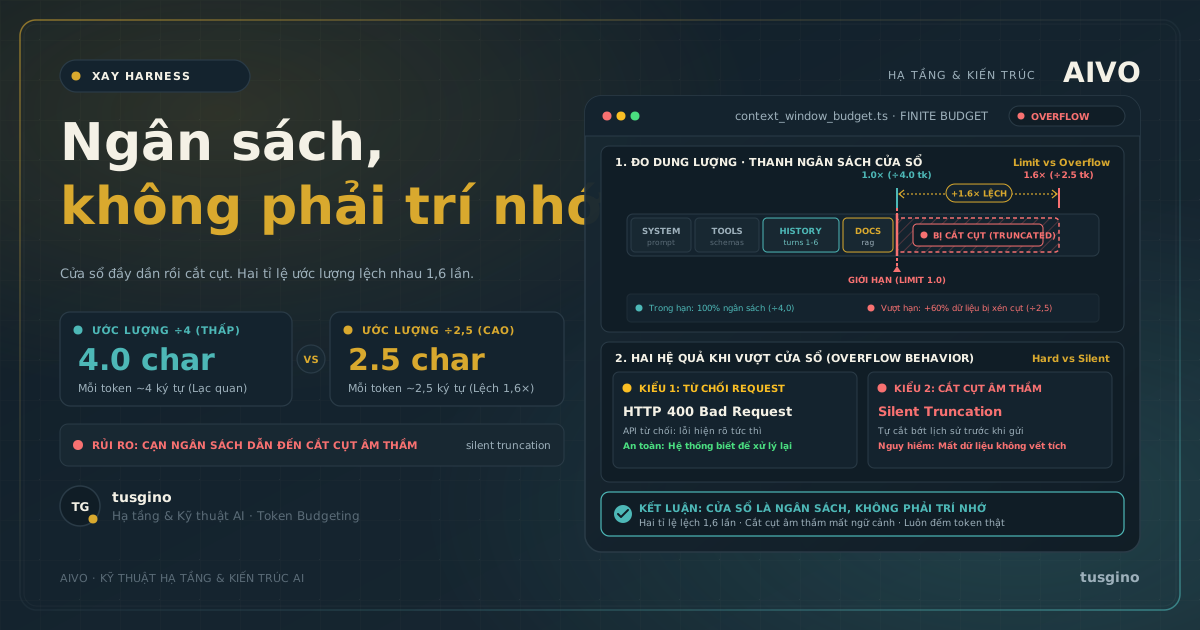
Cửa sổ ngữ cảnh là ngân sách hữu hạn, không phải trí nhớ. Cùng một request, hai tỉ lệ ước lượng token lệch nhau 1,6 lần, và bạn không biết mình ở đâu.