Cắt ngữ cảnh mà vẫn tra lại được
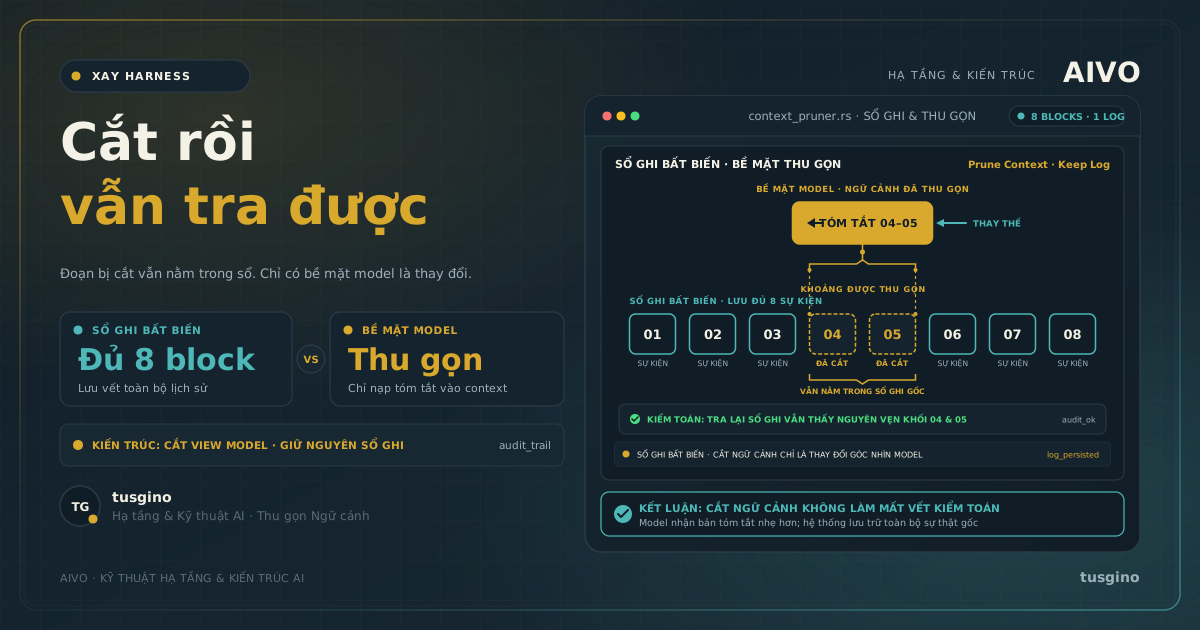
Compaction không xoá gì cả. Nó chỉ che một khoảng trên bề mặt gửi cho model, ghi lại đúng khoảng đã che, và để nguyên bản gốc trong sổ để lần sau tra lại.
Hai chỗ để cắt
Khi ngữ cảnh đầy, bạn phải bỏ bớt. Câu hỏi không phải “bỏ cái gì” mà là bỏ ở tầng nào.
Tầng thứ nhất: trong vòng lặp. Trước khi gọi model, bạn dựng một mảng message mới, ngắn hơn, rồi gửi đi. Mảng cũ biến mất.
Tầng thứ hai: trong sổ. Bạn ghi thêm một event nói rằng “khoảng từ vị trí này tới vị trí kia giờ được thay bằng đoạn tóm tắt này”. Bản gốc vẫn nằm đó.
Cách thứ nhất nhanh và mất dấu. Lần sau bạn đọc lại sổ, bạn thấy một chuỗi event dài đầy đủ. Không có gì nói rằng model đã từng nhìn thấy một phiên bản ngắn hơn. Bạn không trả lời được câu hỏi “vì sao nó trả lời sai”.
Harness tôi đọc chọn cách thứ hai. Compaction ở đây là một capability gắn thêm, không nằm trong xương sống. Không gắn nó thì harness vẫn chạy.
Che, không xoá
Cơ chế nằm gọn trong một kiểu dữ liệu:
type SurfaceOp = | 'append' | { op: 'replace'; startSeq: SessionSeq; endSeq: SessionSeq }'append' là đường thường: thêm vào cuối. 'replace' mang đúng ba trường, không có alias, không có trường thừa. Nó che khoảng bao gồm cả hai đầu, rồi chèn event mới vào chỗ đó.
Và đây là chi tiết làm nên cả bài:
The node’s sourceEventSeqs must include every shadowed surface node.— dsh, docs/subsystems/session.md
Event thay thế phải khai báo đầy đủ những event mà nó che. Không phải một khoảng ước lượng — một danh sách.
Nhờ vậy có hai phép chiếu từ cùng một sổ, và chúng khác nhau một cách có chủ ý. Bề mặt gửi cho model thấy đoạn tóm tắt. Bản ghi cho người đọc vẫn thấy các event gốc.
Bản gốc còn nguyên, và tài liệu của bộ cắt tool result nói thẳng điều đó:
The complete original result remains in the session log for exact replay and inspection.— dsh, packages/compaction/compaction-tool-result-pruner/README.md
Ngưỡng kích hoạt
Công thức thật, đọc từ config.ts:
const thresholdTokens = Math.floor(Math.min( contextWindow * policy.thresholdRatio, pressureBudgetTokens,))Hai vế, lấy vế nhỏ hơn. Vế thứ nhất là một tỉ lệ của cửa sổ ngữ cảnh. Vế thứ hai là ngân sách còn lại sau khi trừ phần dự trữ cho câu trả lời và phần headroom.
Mặc định: thresholdRatio 0,8 và headroomTokens 65.536. Với hai số đó và giả sử không dự trữ token cho câu trả lời, hai vế gặp nhau ở cửa sổ 327.680 token. Dưới mức đó tỉ lệ 0,8 quyết định; trên mức đó phần dự trữ mới là thứ chặn.
| W × 0,8 | W − 65,536 | |
|---|---|---|
| 100 | 80 | 34 |
| 150 | 120 | 84 |
| 200 | 160 | 134 |
| 250 | 200 | 184 |
| 320 | 256 | 254 |
| 400 | 320 | 334 |
| 500 | 400 | 434 |
Xem dữ liệu chart
{"labels": ["100", "150", "200", "250", "320", "400", "500"], "series": [{"name": "W × 0,8", "values": [80, 120, 160, 200, 256, 320, 400]}, {"name": "W − 65,536", "values": [34, 84, 134, 184, 254, 334, 434]}]}Phần giữ lại nguyên văn cũng là một tỉ lệ: 16% của ngân sách message. Và bộ cắt tool result có ba số riêng: cắt khi vượt 8.192 ký tự, giữ 4.096 đầu và 1.024 cuối.
Tài liệu nói rõ vì sao chọn đầu và đuôi. Chọn phần giữa có ý nghĩa thì cần model hoặc luật cấu trúc. Cả hai đều chưa có, nên nó cắt thẳng.
Con số 0,8 không phải chân lý
Đây là chỗ tôi thích nhất, và là chỗ tôi muốn bạn đọc chậm.
Hai tỉ lệ 0,8 và 0,16 nghe như những hằng số đã được chứng minh. Chính README của package nói ngược lại:
Default ratios, undecided — thresholdRatio: 0.8 and retainRatio: 0.16 are fixed defaults; per-model tuning via modelPolicies exists, but no corpus-backed guidance on ideal values is recorded.— dsh, packages/compaction/compaction-basic/README.md:257
Không có tài liệu nào chống lưng cho giá trị tối ưu. 0,8 không phải chân lý. Nó là một con số ai đó chọn, chưa ai đo để bảo vệ.
Cùng một Dev Note còn thừa nhận một chỗ yếu nữa. Bộ đo token dùng heuristic bốn ký tự một token, và heuristic đó định giá thấp văn bản CJK. Với người viết tiếng Việt, đây là chi tiết đáng để ý.
Nói ra hai điều này thì bạn dám chỉnh. Giấu đi thì bạn tưởng 0,8 là chuẩn và không dám động vào.
Crash để lại khoá, không để lại dấu sai
Một lần cắt ngữ cảnh trải qua sáu bước, tất cả trong cùng một giao dịch:
- Kiểm tra khoảng bề mặt còn hợp lệ không.
- Ghi mốc bắt đầu — đây là khoá.
- Gọi model tóm tắt.
- Kiểm tra lại khoảng vừa chọn.
- Ghi event thay thế kèm danh sách event bị che.
- Ghi mốc kết thúc.
Crash giữa chừng thì sao? Tài liệu mô tả cơ chế khoá bằng một câu:
A live unmatched start is the durable lock … A failed close deliberately leaves a blocking orphan.— dsh, packages/compaction/compaction-basic/README.md:125
Đọc vế thứ hai: một lần đóng thất bại cố ý để lại một khoá mồ côi chặn đường.
Đây là thiết kế ngược với phản xạ thường gặp. Nếu bạn ghi một cờ “đã xong” ở cuối, crash sẽ không để lại cờ nào. Bạn không phân biệt được “chưa làm” với “làm rồi nhưng chưa ghi cờ”.
Ghi khoá ở đầu thì crash luôn để lại một dấu hiệu rõ: có ai đó đang làm dở. Hỏng thì ồn ào, không hỏng im.
Nhưng nó tinh tế hơn thế. Một khoá mồ côi trước một session/end-seed mới hơn là dấu vết cũ từ vòng đời trước, và không chặn gì cả. Chỉ khoá nằm sau ranh giới đó mới báo busy.
Xem dữ liệu diagram
type: flowchart
title: Chu trình compaction có khoá an toàn
desc: Kích hoạt tự động hay thủ công đều đi qua một giao dịch có khoá bền vững trước khi tóm tắt
nodes:
  - id: trigger
    label: Kích hoạt compaction
    sub: Vượt áp lực hoặc lệnh /compact
    kind: input
  - id: lock
    label: Ghi mốc bắt đầu (khoá)
    sub: Tránh chạy trùng lặp
    focal: true
  - id: check
    label: Kiểm tra khoảng cần che
    sub: Xác thực tính toàn vẹn
  - id: sum
    label: Gọi model tóm tắt
    kind: external
  - id: replace
    label: Ghi event replace
    sub: Kèm danh sách sourceEventSeqs
    focal: true
  - id: end
    label: Ghi mốc kết thúc
    sub: Mở khoá thành công
edges:
  - [trigger, lock]
  - [lock, check]
  - [check, sum]
  - [sum, replace]
  - [replace, end]
Phản đề: có cách khác tốt hơn
Tôi không thể viết bài này mà bỏ qua một kết quả đi ngược lại nó.
Một bài báo cuối 2025 đề xuất Recursive Language Models. Ý tưởng: coi prompt dài như một môi trường bên ngoài, để model tự chia nhỏ và gọi đệ quy chính nó trên từng đoạn. Nhóm tác giả báo cáo trên GPT-5, lấy trung vị qua bốn bài kiểm tra dài:
RLMs can successfully process inputs up to two orders of magnitude beyond model context windows and, even for shorter prompts, dramatically outperform the quality of vanilla frontier LLMs and common long-context and coding scaffolds (e.g., on GPT-5 by a median across the evaluated benchmarks of 26% against compaction …) across four diverse long-context tasks while having comparable cost.— https://arxiv.org/abs/2512.24601
+26% so với compaction. Không phải một chút.
Tôi đọc con số này theo hai hướng. Nó là một phản đề thật. Nếu bạn đang cân nhắc giữa cắt ngữ cảnh và để model tự chia nhỏ, kết quả trên nghiêng về cách thứ hai.
Nhưng nó không phủ định luận đề của bài này. RLM nói về chiến lược chọn thông tin nào. Bài này nói về tầng nào giữ sự thật.
Bạn có thể chạy RLM và vẫn cần một sổ ghi lại được. Thậm chí cần hơn, vì đệ quy sinh ra nhiều lời gọi hơn để kiểm toán.
Và một chi tiết đáng chú ý: chi phí được mô tả là tương đương, không rẻ hơn. Đổi +26% chất lượng lấy cùng chi phí là một lựa chọn tốt. Nhưng cắt ngữ cảnh vẫn rẻ hơn về số token, vì nó không gọi model thêm lần nào cho việc chia nhỏ.
Cái giá
Mỗi lần cắt là một lần gọi model. Bộ cắt tool result thì không — nó chỉ cắt ký tự — nhưng tóm tắt thì có.
Và vì ngưỡng mặc định chưa ai đo, bạn đang chạy trên một con số không có bằng chứng. Muốn biết 0,8 có đúng cho workload của bạn không, bạn phải tự đo.
Còn có hai chỗ hỏng được nói thẳng. Nếu việc tóm tắt thất bại, bề mặt bền vững gần nhất được giữ nguyên, và lượt đó chạy với lịch sử đầy đủ. Nếu phần dự trữ cho câu trả lời quá lớn, cấu hình bị từ chối ngay lúc dựng, kèm gợi ý giảm headroomTokens.
Đổi lại: cắt xong vẫn tra lại được. Bạn luôn trả lời được câu hỏi model đã thấy gì ở lượt thứ mười bảy.
Làm được ngay
- Cắt ở tầng sổ, không cắt ở tầng vòng lặpGhi lại khoảng đã bị che và giữ nguyên bản gốc. Nhanh hơn một chút không đáng đổi lấy khả năng tra lại.
- Ghi khoá trước, ghi dấu xong sauMột cờ “đã xong” ở cuối không phân biệt được “chưa làm” với “làm dở”. Một khoá ở đầu thì luôn để lại dấu rõ khi crash.
- Khai báo đủ danh sách event bị cheĐừng ghi một khoảng ước lượng. Ghi đúng những event mà event thay thế đang che, để phép chiếu ngược dựng lại được.
- Đo lại hai tỉ lệ mặc định0,8 và 0,16 chưa ai chứng minh. Chúng là điểm bắt đầu, không phải đích.
Nguyên tắc
Cắt ngữ cảnh là thao tác trên bề mặt, không phải trên sự thật. Giữ hai thứ đó tách rời, và mỗi lần model trả lời sai bạn vẫn có đường lần về.
Nếu bạn không replay được lần cắt ngữ cảnh cuối cùng, bạn không kiểm toán được vì sao model trả lời sai. Mọi thứ khác chỉ là đoán.— tusgino
- Compaction che một khoảng trên bề mặt model; bản gốc vẫn nằm trong sổ và vẫn replay được.
- Ngưỡng là
floor(min(W × 0,8; ngân sách sau dự trữ)); hai vế gặp nhau ở cửa sổ 327.680 token với mặc định hiện tại. - Hai tỉ lệ 0,8 và 0,16 là mặc định chưa có bằng chứng, chính README nói vậy.
- Crash để lại khoá mồ côi chặn đường — hỏng ồn ào thay vì hỏng im.
- Phản đề đáng kể: Recursive Language Models báo +26% chất lượng so với compaction trên GPT-5, với chi phí tương đương.
Câu hỏi thường gặp
Compaction có xoá lịch sử không?
Ngưỡng kích hoạt compaction lấy từ đâu?
Vì sao không cắt thẳng trong vòng lặp cho nhanh?
Crash giữa lúc đang cắt thì sao?
Bài liên quan
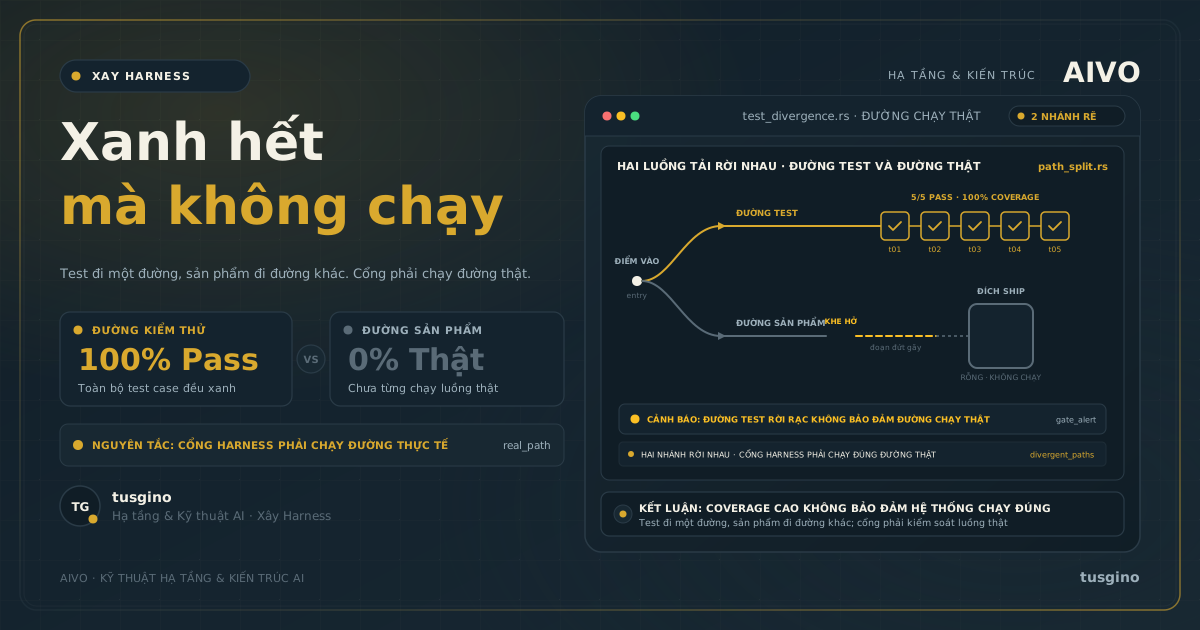
Coverage 100% mà vẫn không chạy
Một tính năng chết hẳn trong sản phẩm, trong khi 178 test xanh và coverage vẫn 100%. Coverage đo dòng đã chạy, chứ không đo đường mà sản phẩm thật sự đi.
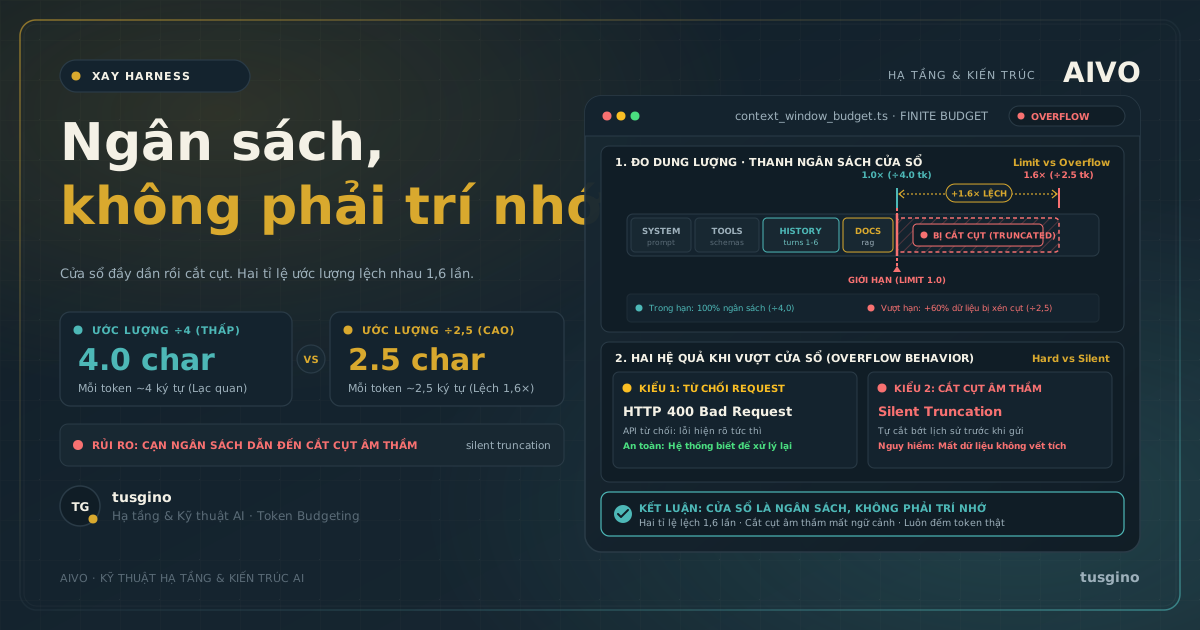
Cửa sổ ngữ cảnh không phải trí nhớ
Cửa sổ ngữ cảnh là ngân sách hữu hạn, không phải trí nhớ. Cùng một request, hai tỉ lệ ước lượng token lệch nhau 1,6 lần, và bạn không biết mình ở đâu.
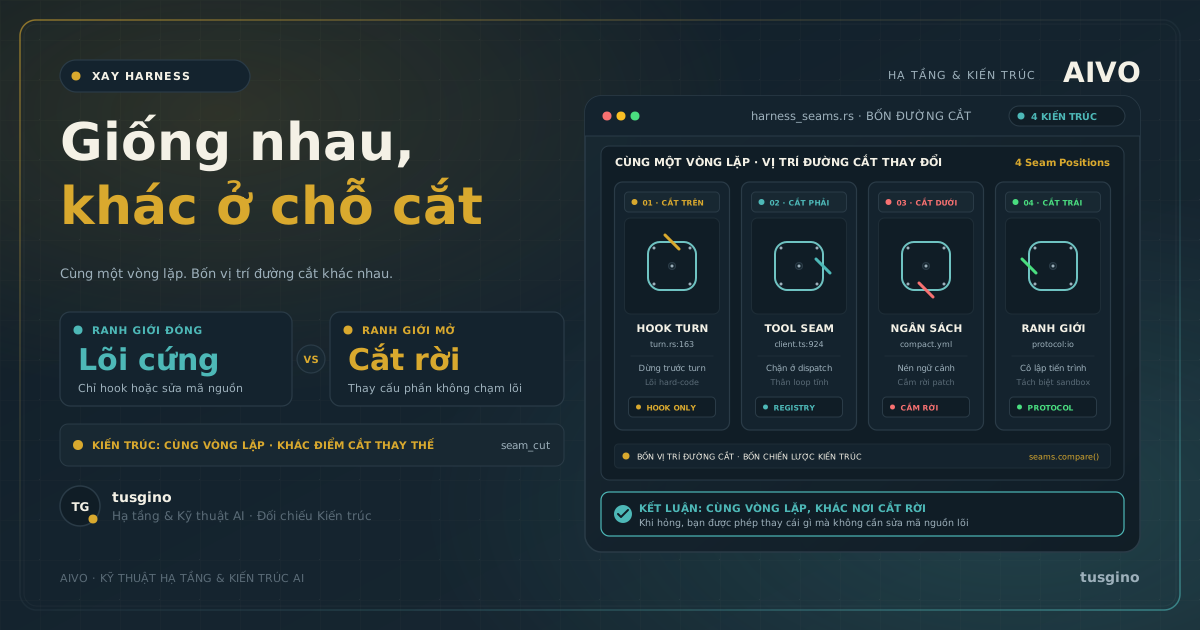
Vòng lặp giống nhau, chỗ thay được thì khác
Mọi harness đều có sổ ghi, sổ tool, ngân sách và tầng quyền. Chúng khác nhau ở chỗ cái nào bạn được phép thay — tôi đã đọc mã nguồn bốn harness để trả lời.