Một lần gọi API, rồi quên hết
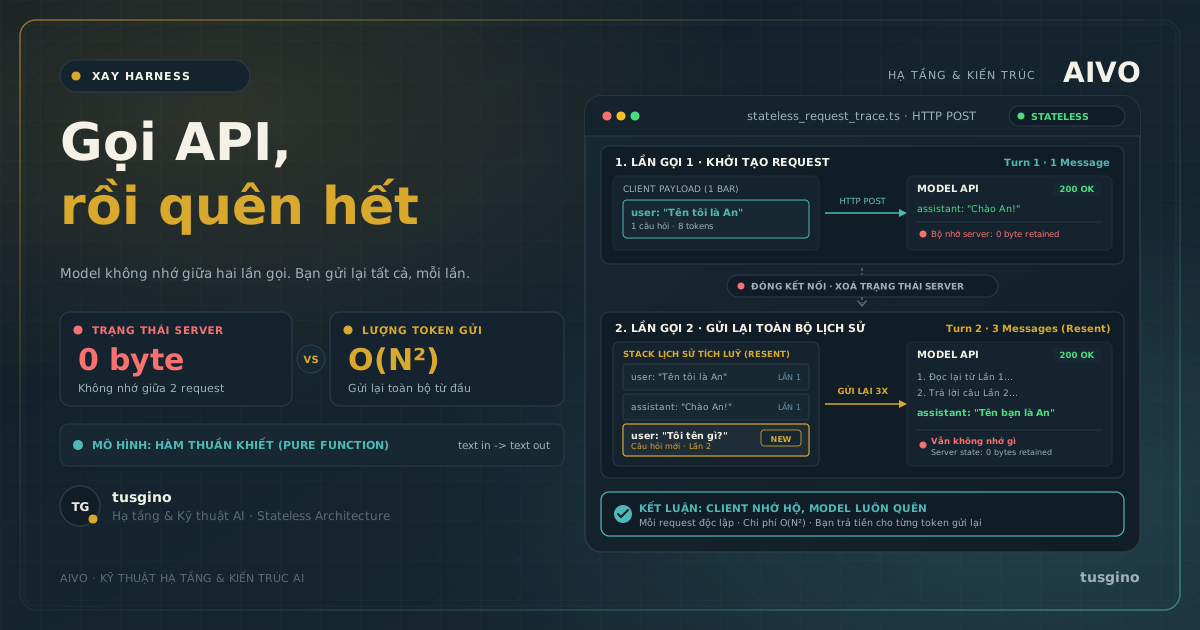
Mỗi lần gọi API là một hàm thuần: text vào, text ra, xong là hết. Cái bạn tưởng là trí nhớ của model thực ra là lịch sử bạn tự gửi lại, và bạn trả tiền cho nó.
Nghịch lý của lần gọi thứ hai
Mở một cửa sổ chat, kể cho model nghe tên bạn. Nó trả lời đúng tên đó. Đóng cửa sổ, mở cửa sổ mới, hỏi lại. Nó không biết bạn là ai.
Hầu hết người dùng gặp nghịch lý này đều giải thích sai. Họ tưởng model nhớ trong một phiên và quên giữa các phiên. Sự thật khó chịu hơn: model không nhớ gì cả, kể cả trong cùng một phiên.
Thứ làm nên ảo giác đó nằm ở client. Mỗi lần bạn gõ thêm một câu, client gửi lại toàn bộ đoạn hội thoại từ đầu. Model đọc lại từ số 0 rồi trả lời câu mới nhất.
Không phải suy đoán. Tài liệu DeepSeek nói thẳng điều đó:
“The DeepSeek
/chat/completionsAPI is a ‘stateless’ API, meaning the server does not record the context of the user’s requests. Therefore, the user must concatenate all previous conversation history and pass it to the chat API with each request.”
Ba câu, và câu thứ hai là toàn bộ luận đề của bài này. Tài liệu API reference mô tả trường messages đúng một dòng: “A list of messages comprising the conversation so far.”
Nhưng cần nói rõ một ngoại lệ: không phải mọi API đều là không trạng thái (stateless).
Google hiện có API Interactions quản lý trạng thái hội thoại phía server. Bạn bật nó bằng previous_interaction_id, và từ chối bằng store=false. Nghĩa là “API LLM không có trí nhớ” đã trở thành một lựa chọn thiết kế, không còn là một định luật bất biến.
Và đây là một sự đánh đổi kiến trúc thật sự: mô hình không trạng thái bắt bạn trả thêm băng thông ở mỗi lượt gửi để đổi lấy toàn quyền kiểm soát lịch sử. Mô hình có trạng thái phía server giữ kích thước payload nhỏ gọn, nhưng cái giá phải trả là trạng thái và vòng đời hội thoại nằm ngoài tầm kiểm soát của bạn.
// Không có API key nào ở đây. Hàm này cố ý giả lập để lộ ra cấu trúc dữ liệu.type Message = { role: 'user' | 'assistant'; content: string };
declare function callModel(messages: Message[]): Promise<string>;
const history: Message[] = [];
async function ask(text: string): Promise<string> {  history.push({ role: 'user', content: text });
  // Chú ý dòng này: gửi TOÀN BỘ mảng, không phải chỉ câu vừa gõ.  const reply = await callModel(history);
  history.push({ role: 'assistant', content: reply });  return reply;}
Cả hai dòng history.push đều bắt buộc. Bỏ dòng thứ hai đi thì lượt sau model sẽ trả lời như chưa từng nghe thấy câu trước.
Xem dữ liệu diagram
type: sequence
title: Hai lần gọi API, lần thứ hai gửi kèm lịch sử
desc: Lần gọi thứ nhất chỉ có một câu hỏi; lần gọi thứ hai phải gửi lại toàn bộ lịch sử để model hiểu ngữ cảnh
nodes:
  - id: app
    label: Ứng dụng
    kind: input
    focal: true
  - id: model
    label: LLM API
    kind: external
edges:
  - [app, model]
  - [model, app]
  - [app, model]
  - [model, app]
Ba con số định lượng nghịch lý đó
Không cần API key để thấy cái giá. Hai phép đo dưới đây chạy bằng node, và script nằm trong repo này tại docs/research/measure-resend-cost.mjs.
Phép đo thứ nhất: cùng một nội dung, viết bằng hai ngôn ngữ.
| Ngôn ngữ | Ký tự | Byte | Byte mỗi ký tự |
|---|---|---|---|
| Tiếng Việt | 169 | 230 | 1,361 |
| Tiếng Anh | 190 | 190 | 1,000 |
Tiếng Việt tốn thêm 36% byte cho cùng lượng thông tin.
Phép đo thứ hai: gửi lại lịch sử ở mỗi lượt, giả định các lượt dài bằng nhau.
| Lượt | Lịch sử lượt đó | Tổng đã gửi | Bội số |
|---|---|---|---|
| 3 | 3 | 6 | 2× |
| 6 | 6 | 21 | 3,5× |
| 10 | 10 | 55 | 5,5× |
| 20 | 20 | 210 | 10,5× |
Con số thứ nhất và thứ ba là phép đo byte, tất định, không phụ thuộc model nào. Con số thứ hai là số học, không phải phép đo: nó chỉ là tổng .
Công thức của nó gọn đến mức đáng ngờ:
Tổng đã gửi, tính theo số lượt :
Ở 6 lượt bạn đã trả 3,5 lần. Ở 20 lượt là 10,5 lần. Không có ngưỡng nào ở đó cả — chi phí tăng bậc hai, còn giá trị nhận được thì không.
Cái bạn tưởng là trí nhớ thực ra là một biến
Định nghĩa gọn nhất của một lần gọi LLM: một hàm thuần biến một mảng message thành một chuỗi ký tự. Không đọc file, không giữ session, không nhớ request trước.
Hệ quả là mọi thứ bạn gọi là “trí nhớ” đều nằm ở phía bạn. Cụ thể là trong một biến mảng, một bảng database, hoặc một file log.
Xem dữ liệu diagram
type: flowchart
title: Lịch sử là thứ bạn sở hữu, không phải model
desc: Ứng dụng giữ mảng lịch sử; mỗi lượt gửi lại cả mảng; model chỉ thấy mảng đó và không giữ gì sau khi trả lời
nodes:
  - id: user
    label: Người dùng gõ
    kind: input
  - id: store
    label: Mảng lịch sử
    kind: store
    focal: true
  - id: model
    label: Model trả lời
  - id: reply
    label: Ghi câu trả lời
    kind: store
edges:
  - [user, store]
  - [store, model]
  - [model, reply]
- [reply, store]- Tin rằng model nhớ giữa các lượt.
- Không kiểm soát được cái gì đang thật sự nằm trong ngữ cảnh.
- Khi model trả lời sai, không có bản ghi nào để đọc lại.
- Lịch sử nằm rải rác ở client, không ai là nguồn sự thật.
- Lịch sử là dữ liệu của ứng dụng, có schema và có chủ.
- Mỗi lượt gửi là một phép biến đổi đọc được, kiểm toán được.
- Chèn hay cắt một message là thao tác có kiểm soát.
- Cái giá: bạn phải tự quản lý vòng đời của mảng đó.
Cách thứ hai không miễn phí. Nó biến một chi tiết giao diện thành một bài toán dữ liệu. Mảng dài bao nhiêu thì cắt, cắt theo tiêu chí nào, và bản ghi gốc để đâu.
Ba tầng của cùng một sự thật
Tầng hàm: request không mang trạng thái
Một request gồm model, mảng message, và vài tham số sinh văn bản. Không có trường session, không có mã hội thoại, không có trường bộ nhớ.
Nghĩa là hai request giống hệt nhau sẽ cho kết quả gần như giống hệt nhau. Điều đó đúng bất kể trước đó bạn đã gọi bao nhiêu lần. Model không tích lũy gì theo thời gian.
Tầng ứng dụng: mảng lịch sử là database của bạn
Đến đây mọi thứ đã rõ. history trong đoạn code đầu bài không phải một biến tiện tay. Nó là nguồn sự thật duy nhất về việc cuộc hội thoại đã đi qua đâu.
Và vì nó là nguồn sự thật, nó thừa hưởng mọi vấn đề của một nguồn sự thật. Ghi đồng thời, khôi phục sau crash, schema thay đổi, và câu hỏi ai được quyền sửa nó.
Tầng chi phí: ngôn ngữ quyết định giá
Phép đo đầu tiên đáng dừng lại lâu hơn. Cùng một nội dung, tiếng Việt chiếm 1,36 byte mỗi ký tự; tiếng Anh ASCII chiếm đúng 1,00.
Mọi ngưỡng đếm theo byte đều chặt hơn với người viết tiếng Việt. Không phải vì tiếng Việt dài dòng, mà vì dấu tiếng Việt cần nhiều byte hơn trong bảng mã UTF-8.
Mình phải nói rõ giới hạn của phép đo này: nó đo byte, không đo token. Token là đơn vị do tokenizer của từng model quyết định, và tỉ lệ ký tự trên token khác nhau giữa các model. Muốn có số token thật thì phải chạy đúng tokenizer đó. Con số 36% là bằng chứng về chiều hướng, không phải một hệ số quy đổi.
Việc làm được ngay: biến lịch sử thành dữ liệu có chủ
Nếu model là hàm thuần, thì chỗ duy nhất có thể sai nằm ở dữ liệu bạn gửi vào. Ba bước, làm được trong một buổi.
- Chọn một nguồn sự thậtChốt rằng chỉ có đúng một nơi lưu lịch sử. Nếu hiện tại client và server mỗi bên giữ một bản, chọn một bên và xoá bên kia.
- Ghi trước khi gọiGhi message của người dùng xuống nguồn đó trước khi gọi model. Nếu tiến trình chết giữa chừng, bạn vẫn biết mình đã hỏi gì.
- Đếm cái mình gửiLog số đơn vị của mỗi request. Đây là con số duy nhất cho biết chi phí gửi lại đang tăng nhanh hay chậm.
Bước thứ hai là bước hay bị bỏ nhất, và cũng là bước rẻ nhất. Một dòng ghi trước khi gọi model đổi được câu hỏi “vì sao nó trả lời thế” từ phỏng đoán thành tra cứu.
Một cái bẫy: user_id không phải trí nhớ
Schema có một trường tên user_id, và nó rất dễ bị đọc thành “mã để model nhớ bạn”. Docs nói rõ ba mục đích của nó: kiểm duyệt an toàn nội dung, cô lập KVCache, và cô lập lịch. Không mục đích nào là ghi nhớ hội thoại.
Điểm này quan trọng vì prompt cache hay bị hiểu sai thành trạng thái. Cache là tối ưu hiệu năng cho phần prefix đã tính, không phải trạng thái ứng dụng. Nó không đổi hợp đồng: bạn vẫn phải gửi đủ messages.
Trường usage trong response nói rõ điều đó. prompt_tokens bằng prompt_cache_hit_tokens cộng prompt_cache_miss_tokens, nghĩa là phần trúng cache vẫn nằm trong prompt bạn đã gửi. Cache làm rẻ đi một phần, không xoá chi phí.
Nguyên tắc
Model không nhớ. Bạn nhớ. Mọi thứ bạn gọi là ngữ cảnh đều là dữ liệu do bạn chọn gửi, và bạn trả tiền cho từng lần gửi lại nó.
Model không nhớ gì cả. Cái bạn gọi là trí nhớ chính là dữ liệu bạn chọn gửi lại.— tusgino
- Ghi message của người dùng xuống nguồn sự thật trước khi gọi model — một dòng, và nó đổi cách bạn debug.
- Đặt lịch sử vào một nguồn sự thật duy nhất; hai bản sao ở hai tầng là hai bản sao sẽ lệch nhau.
- Nhớ công thức khi ước lượng chi phí: ở 20 lượt bạn đã trả 10,5 lần độ dài lịch sử cuối cùng.
- Đừng quy đổi byte sang token. Đo byte thì tất định; muốn token thật thì chạy đúng tokenizer của model bạn dùng.
- Với tiếng Việt, ngân sách byte chặt hơn tiếng Anh 36% cho cùng nội dung — đặt ngưỡng cắt theo số đo của chính bạn.
Câu hỏi thường gặp
Tại sao giao diện chat trông như model nhớ, nếu API không nhớ gì?
Gửi lại lịch sử tốn thêm bao nhiêu?
Tiếng Việt có tốn token hơn tiếng Anh không?
Bài liên quan
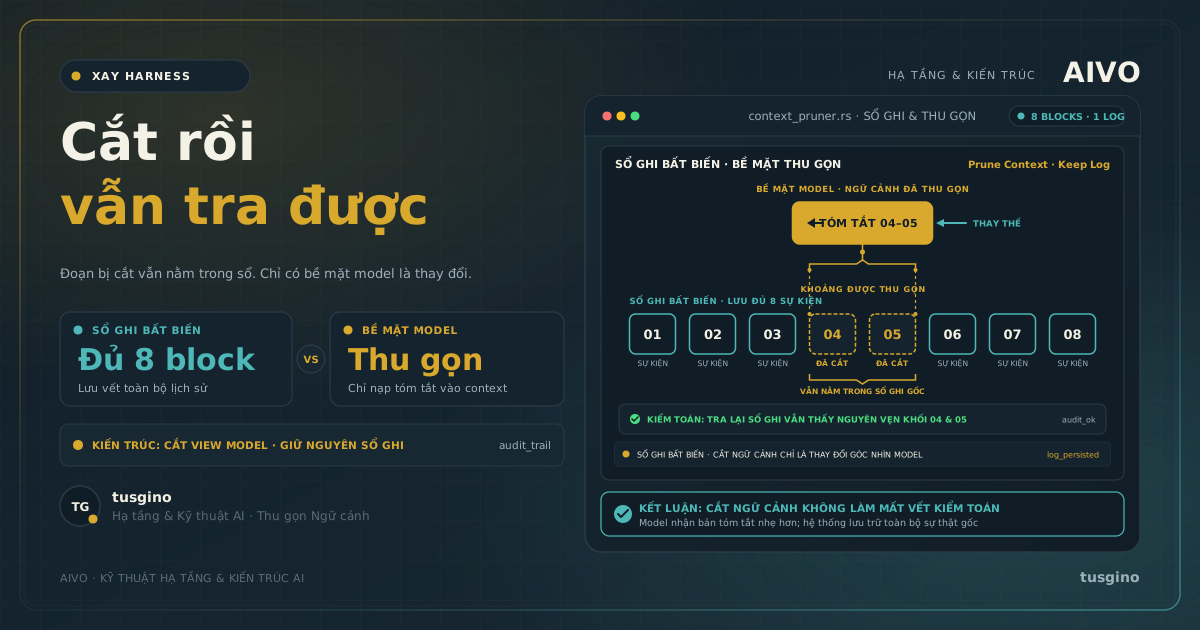
Cắt ngữ cảnh mà vẫn tra lại được
Compaction không xoá gì cả. Nó chỉ che một khoảng trên bề mặt gửi cho model, ghi lại đúng khoảng đã che, và để nguyên bản gốc trong sổ để lần sau tra lại.
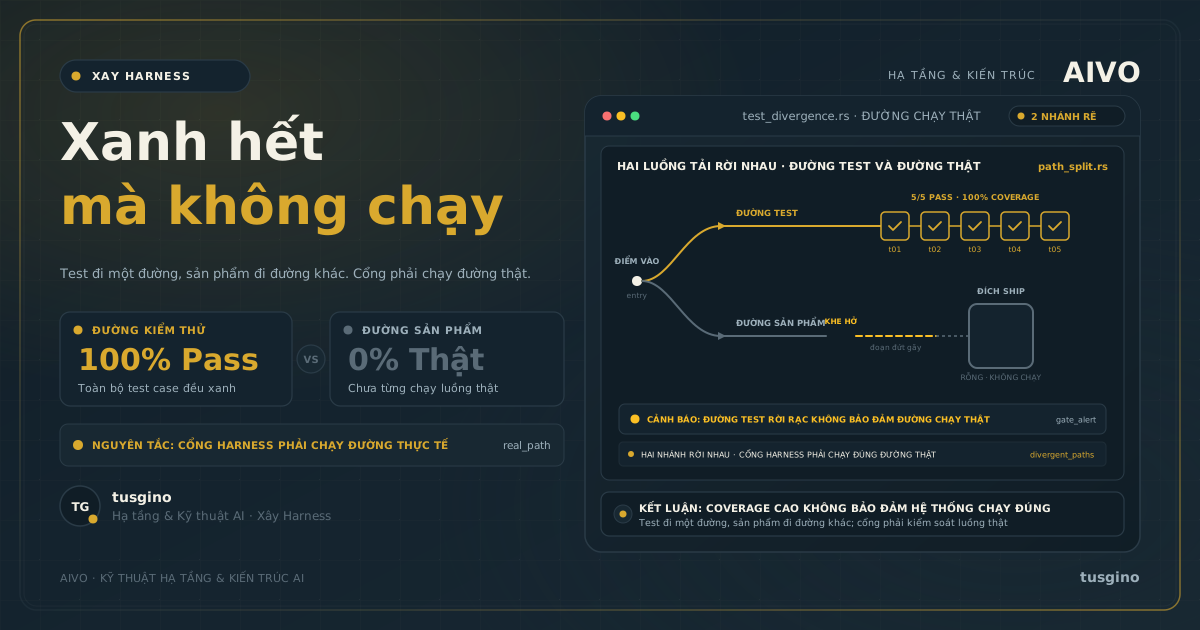
Coverage 100% mà vẫn không chạy
Một tính năng chết hẳn trong sản phẩm, trong khi 178 test xanh và coverage vẫn 100%. Coverage đo dòng đã chạy, chứ không đo đường mà sản phẩm thật sự đi.
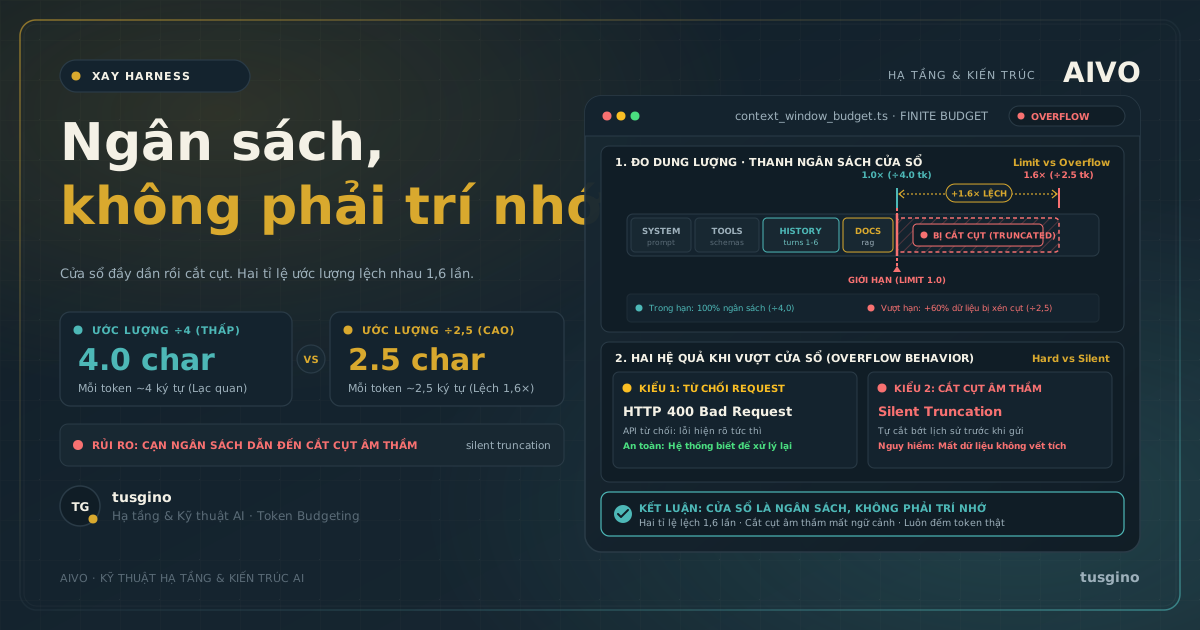
Cửa sổ ngữ cảnh không phải trí nhớ
Cửa sổ ngữ cảnh là ngân sách hữu hạn, không phải trí nhớ. Cùng một request, hai tỉ lệ ước lượng token lệch nhau 1,6 lần, và bạn không biết mình ở đâu.